 数字先锋AI
 2026年07月07日

Anthropic 在 Claude Sonnet 5 上抛出了一个诱人的命题:以 Opus 4.8 六成左右的价格,提供接近旗舰九成的性能。这是 "most agentic Sonnet yet"(最具 Agent 能力的 Sonnet),被不少开发者视为 Opus 4.8 的平价替代。
但"单价便宜"和"账单便宜"是两件事。Sonnet 5 的核心升级在于更强的 Agent 与思维链(thinking)能力,而这恰恰意味着它在执行同一任务时可能消耗更多 token。公开第三方实测普遍指向一个反直觉的结论:标称降价 6 成,实际账单可能不降反升。
这篇文章基于 Anthropic 官方发布与公开第三方评测,帮你判断 Sonnet 5 究竟是 Opus 平替,还是一笔需要算清楚的账。
说明: 本文的能力描述来自 Anthropic 官方发布页与公开第三方评测,非本站实测。涉及的能力结论均标注来源,价格数据为 QuickRouter 控制台实时值。建议你用注册赠送的额度,拿自己的真实任务验证。
一、Sonnet 5 在卷什么?官方公布的三件事
根据 Anthropic 官方发布(2026-06-30),Sonnet 5 的升级重点集中在三个方向,全部围绕"让中端模型也能干 Agent 的活"。
1. Coding 与 Agentic 任务大幅追近 Opus
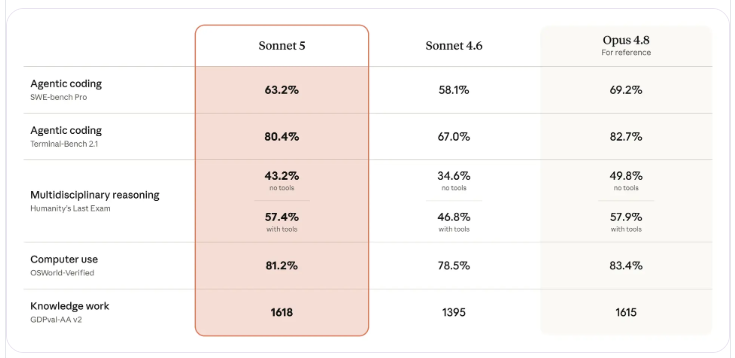
官方明确表示,相比 Claude Sonnet 4.6,最大的提升在 coding 和 agentic 任务。在 Anthropic 自家的多步智能体基准上,Sonnet 5 与 Opus 4.8 的差距被压缩到了历史最小——这正是"Opus 九成实力"叙事的来源。
2. 更强的"思维链"与工具调度
Sonnet 5 强化了 extended thinking(扩展思维)与工具并行调用能力。模型能在单次任务里自主规划多步、并行调度搜索/代码执行等子工具,并把中间结果串成一条完整的执行链。
3. 诚实度与对齐改进
延续 Opus 4.8 的方向,Sonnet 5 在"行为不匹配"(misaligned behavior)评估上继续优化,降低了过度自信和"硬装知道"的倾向。
官方公布的基准成绩对比,直观展现了 Sonnet 5 的定位——在多数 Agent / coding 基准上逼近 Opus 4.8:
二、Sonnet 5 vs Opus 4.8:公开实测怎么看?
光看官方跑分不够直观。下面用公开第三方评测的典型结论,把 Sonnet 5 和 Opus 4.8 在具体维度上的差异整理成对比。以下结论来自公开第三方评测,非本站实测。
维度 1:Agent / 长链路任务
| 对比维度 | SONNET 5 | OPUS 4.8 |
|---|---|---|
| 多步任务完成率 | 接近 Opus,差距收窄至个位数百分点 | 基准最高 |
| 工具调度稳定性 | 强,偶有冗余调用 | 更精炼 |
| 思维链长度 | 更长(思考更展开) | 相对克制 |
来源:公开第三方评测,2026-07
这对开发者意味着什么:如果你的场景是"让 AI 端到端跑完一个多步任务"(数据抓取、批量研究、自动化流程),Sonnet 5 已经能逼近 Opus 的完成率。但注意第三行——它的思维链更长,这是后面"账单反差"的伏笔。
维度 2:Coding 与工程改动
| 对比维度 | SONNET 5 | OPUS 4.8 |
|---|---|---|
| 单文件 / 函数级改动 | 与 Opus 几乎打平 | 持平 |
| 跨文件仓库级改动 | 强,但极限场景略逊 | 仍是最稳 |
| 大型代码迁移(如 75 万行级) | 不推荐 | Dynamic Workflows 主场 |
来源:公开第三方评测,2026-07
这对开发者意味着什么:日常 coding(写函数、改 bug、做组件)Sonnet 5 完全够用,单价还便宜一大截;但遇到跨仓库的大规模重构、关键零幻觉场景,Opus 4.8 仍是更稳妥的选择。
维度 3:单价 vs 实际账单(核心反差)
这是 Sonnet 5 最值得关注的地方——单价便宜,不等于总账单便宜。
| 对比维度 | SONNET 5 | OPUS 4.8 |
|---|---|---|
| 输入单价 | $3/M tokens(约 Opus 的 60%) | $5/M tokens |
| 输出单价 | $15/M tokens(约 Opus 的 60%) | $25/M tokens |
| 同任务 token 消耗 | 明显更高(思维链更长) | 较低 |
| 同任务实际账单 | 可能持平甚至更高 | 基准 |
来源:公开第三方评测,2026-07
这笔账要算清: Sonnet 5 的思维链(thinking)token 在很多任务里会显著膨胀。不要看到"单价降 6 成"就直接切过去——如果你的任务触发大量推理,实际花费可能不降反升。最稳妥的做法是用你自己的真实任务跑一次,对比总 token 消耗再决定。
能力总览:六维评分与雷达图
把 Claude Sonnet 5 与上一代 Sonnet 4.6 放在六个维度上横向对比,能力差异一目了然:
| 测评点 | CLAUDE SONNET 5 | SONNET 4.6 |
|---|---|---|
| 推理 | ★★★★☆A 级 | ★★★★☆A 级 |
| 代码 | ★★★★½S 级 | ★★★★☆A 级 |
| 数学 | ★★★★☆A 级 | ★★★★☆A 级 |
| 多模态 | ★★★★☆A 级 | ★★★★☆A 级 |
| 长上下文 | ★★★★½S 级 | ★★★★☆A 级 |
| 工具调用 | ★★★★½S 级 | ★★★★☆A 级 |
能力维度评分(5 星制,依据官方公布的基准成绩归一化)。来源:各厂商官方发布,非本站实测
相比 Sonnet 4.6,Sonnet 5 的提升集中体现在代码(+4)和工具调用(+6)——这正是 Anthropic 主打的 "agentic Sonnet" 定位。推理和数学相对只涨 4 分左右,说明这一代并不是"全面刷榜",而是把火力精准对准了 Agent 落地最需要的两个维度。
三、它值多少钱?实时价格
下面是 QuickRouter 控制台的实时价格——显示的是人民币,充值比例 ¥1 = $1,所以你看到的数字就是用人民币充值后实际要付的价,不用再换算。
实时价格 · claude-sonnet-5
人民币计价 · 充值比例 ¥1 = $1 · 数据来自 QuickRouter 控制台
按官方计费规则,人民币充值,无需海外信用卡。
为了直观对比"什么时候用 Sonnet 5、什么时候上 Opus",这里是三者横向比价:
Sonnet 5 / Opus 4.8 / Sonnet 4.6 价格对比
人民币 · 每 100 万 tokens · 充值比例 ¥1 = $1 · 数据来自 QuickRouter 控制台
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| claude-sonnet-5 | Anthropic | 文本 | ¥2.00/百万token | ¥10.00/百万token |
| claude-opus-4-8 | Anthropic | 文本 | ¥5.00/百万token | ¥25.00/百万token |
| claude-sonnet-4-6 | Anthropic | 文本 | ¥3.00/百万token | ¥15.00/百万token |
怎么选最省
单价上 Sonnet 5 明显低于 Opus 4.8,但真正决定成本的是"单价 × token 量"。短任务、轻推理 → Sonnet 5 性价比突出;长链路 Agent 任务 → 一定要先实测 token 消耗,再决定是否比 Opus 划算。
四、该不该用它?
基于官方数据和公开评测,给你一个判断框架:
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 日常 coding、写工具、做组件 | Sonnet 5 | 单价低,coding 能力已逼近 Opus |
| 多步 Agent 任务(成本不敏感) | Sonnet 5 | 工具调用 +6,agentic 能力大幅提升 |
| 多步 Agent 任务(成本敏感) | △ 先实测 | 思维链更长,账单可能反超 Opus,需对比 token 量 |
| 大型代码迁移 / 跨仓库重构 | Opus 4.8 | Dynamic Workflows 仍是这类任务的唯一解 |
| 需要零幻觉(法律/医疗/数据) | Opus 4.8 | 对齐与诚实度评估仍领先 |
| 纯跑量、成本极度敏感 | Sonnet 4.6 或更便宜的模型 | Sonnet 5 的 thinking 会让账单不可控 |
一句话总结:Sonnet 5 是目前最接近 Opus 的中端模型,但它不是"便宜的 Opus",而是"会想更多的 Sonnet"。想清楚你为"想更多"付的钱,到底是值还是亏。
注册 QuickRouter 后送的免费额度,足够你拿自己的真实任务验证"单价 vs 账单"这笔账——用自己的数据做决定,比看任何评测都准。
信息来源:本文能力描述来自 Anthropic 官方 Sonnet 5 发布、Claude 平台文档及公开第三方评测,非本站实测。价格数据为发布当日(2026-07-04)QuickRouter 控制台快照,最新价格请以控制台价格页为准。